
Klasik arama kelime eşleştirir: "araç" yazarsanız "araç" geçen belgeleri bulur, "otomobil" geçenleri kaçırır. Ama insan zihni böyle çalışmaz; biz anlamı ararız. RAG, öneri sistemleri ve modern arama motorlarının kalbindeki sihir, tam da makinelere bu yeteneği kazandırıyor. Adı: embedding.
Bu yazı, önceki yazıların altında sessizce çalışan makineyi açıyor. RAG'in "benzerlik araması" nasıl oluyor? Mimariler yazısındaki o "anlam koordinatları" tam olarak ne? Ve milyonlarca metin içinde doğru olanı saniyeler içinde nasıl buluyoruz? Hepsi burada.
Anlamı sayıya çevirmek
Bilgisayar kelimeleri anlamaz, sayıları anlar. Embedding, bir metni (bir kelimeyi, bir cümleyi, bir belgeyi) onun anlamını temsil eden bir sayı dizisine (vektöre) çevirmektir. Bu vektör tipik olarak yüzlerce boyuttan oluşur; her boyut, modelin öğrendiği bir anlam özelliğini yakalar.
Sihir şurada: bu sayılar rastgele değildir. Anlamca yakın metinler, bu sayı uzayında da birbirine yakın yerleştirilir. Yani anlam, artık bir konum meselesi hâline gelir. "Kral" ve "kraliçe" birbirine yakın oturur; "kral" ve "muz" uzakta.
Anlam haritası
Yüzlerce boyutu gözünüzde canlandıramazsınız; kimse canlandıramaz. Ama fikri iki boyuta indirgeyip bir harita gibi düşünebiliriz:
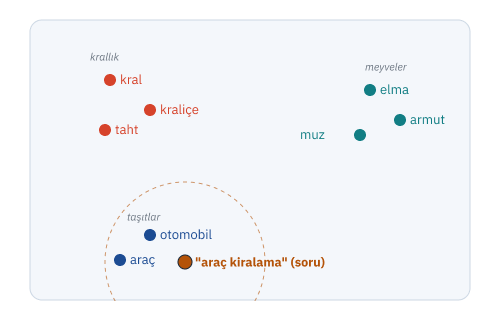
Bu haritada arama yapmak, kelime eşleştirmekten tamamen farklıdır. "Araç kiralama" diye sorduğunuzda, sistem bu sorunun vektörünü hesaplar ve haritada ona en yakın noktaları bulur; belgede "otomobil kira bedeli" yazsa bile, çünkü onlar da aynı bölgede oturur.
Yakınlığı nasıl ölçeriz? Kosinüs benzerliği
Peki iki vektörün "yakın" olduğunu tam olarak nasıl hesaplarız? En yaygın yöntem kosinüs benzerliği: iki vektör arasındaki açıya bakmak. Aynı yöne bakan iki ok (küçük açı) = benzer anlam; farklı yönlere bakanlar (geniş açı) = farklı anlam. Büyüklük değil, yön önemlidir.
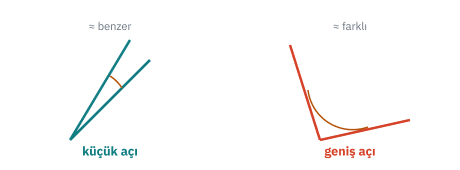
Milyonlarca vektörü hızlıca aramak: vektör veritabanı
Bir sorun var: elinizde milyonlarca belge parçası olabilir. Her arama için hepsini tek tek karşılaştırmak (kaba kuvvet) çok yavaştır. İşte burada vektör veritabanları devreye girer. Onların işi, bu devasa anlam haritasında doğru komşuları neredeyse anında bulmak.
Bunu yaklaşık en yakın komşu (ANN, Approximate Nearest Neighbor) denen zekice bir hileyle yaparlar. En popüler yöntem HNSW: vektörleri katmanlı bir "kısa yollar ağı" olarak düzenler; böylece milyonlarca nokta arasında gezinmek, tek tek bakmak yerine kestirmelerle olur. Sonuç: arama karmaşıklığı kabaca O(n)'den O(log n)'e düşer: yani devasa hızlanma.
Küçük bir takas: "Yaklaşık" kelimesi önemli: vektör veritabanları mükemmel doğruluğu, muazzam hız için biraz feda eder. Ama pratikte doğruluk %90-99 aralığında kalır; bu kadar hızlanmaya karşılık kabul edilebilir, hatta çoğu iş için mükemmelden daha değerli bir denge.
Bu işi yapan hazır araçlar var: Chroma, Qdrant, Weaviate, Pinecone, pgvector ve daha fazlası. Küçük, yerel bir kurulum için açık kaynak bir embedding modelini Chroma veya Qdrant ile eşleştirmek yeterli; hatırlarsanız, yerel LLM yazımızdaki "yerel RAG" tam olarak böyle kurulur.
Nerede karşımıza çıkıyor?
Embedding'ler, farkında olmadan her gün kullandığınız pek çok şeyin altında çalışır:
- Anlam araması (semantic search): kelime değil, niyet üzerinden arama.
- RAG: "RAG nedir" yazısındaki o benzerlik araması: işte bu embedding'lerle olur.
- Öneri sistemleri: "buna benzer ürünler/şarkılar/yazılar".
- Kümeleme ve tekilleştirme: benzer belgeleri gruplamak, tekrarları bulmak.
Türkçe için: embedding de bir seçim
Önemli bir nokta: bir RAG veya arama sistemi kurarken, seçtiğiniz embedding modeli en az dil modeli kadar önemlidir. Çünkü anlamı yanlış haritalayan bir embedding, sistemin tamamını çökertir.
İyi haber: Türkçe için seçenekler var. Çok dilli güçlü modeller (yaklaşık 100 dili kapsayan BGE-M3, Nomic Embed v2 gibi) Türkçeyi de içerir; ayrıca doğrudan Türkçeye odaklı embedding modelleri geliştiriliyor (örneğin 768 boyutlu vektörler ve 8.192 token bağlam üreten Türkçe cümle embedding modelleri). Bunları sentence-transformers gibi kütüphanelerle yerelde çalıştırabilirsiniz.
Yine veri ve dil meselesi: Türkçenin eklemeli yapısı, embedding kalitesini de etkiler. Çok dilli bir model Türkçeyi "idare eder" ama Türkçeye özel eğitilmiş/uyarlanmış bir model çoğu zaman daha isabetli haritalar çıkarır. Yani modeller gibi, embedding'lerde de "yerli ve uyarlı" önemli.
lleaderboard açısından
Bir ekosistemin sadece dil modellerini değil, embedding modellerini de ölçmesi gerekir; çünkü RAG ve aramanın kalitesi doğrudan onlara bağlı. "Hangi Türkçe embedding modeli, hangi iş için daha iyi anlam haritası çıkarıyor?" sorusu, tıpkı LLM'lerde olduğu gibi şeffaf biçimde cevaplanmayı hak ediyor. lleaderboard için embedding karşılaştırması, haritanın eksik ama önemli bir parçası.
Özet: Embedding, anlamı sayıya (vektöre) çevirir; yakın anlamlar uzayda yakın oturur. Kosinüs benzerliği yakınlığı ölçer. Vektör veritabanları (HNSW/ANN) milyonlarca vektörde doğru komşuyu anında bulur. Bu makine, RAG'in, aramanın ve önerinin altında çalışır; Türkçe için de embedding seçimi kritik.
Anlamı bir haritaya dökmek, kulağa soyut gelse de bugünkü yapay zekânın en pratik fikirlerinden biri. Bu haritayı Türkçe için ne kadar iyi çizersek, arama, asistan ve bilgi sistemlerimiz o kadar isabetli olur. Ve bu harita da, tıpkı modeller gibi, topluluğun ortak eseri olacak.
Kaynaklar
- Understanding Semantic Search: Vector Embeddings & Similarity — Medium
- The Complete Guide to Vector Databases — MachineLearningMastery
- HNSW Indexing in Vector Databases — Medium
- The Best Open-Source Embedding Models in 2026 — BentoML
- Best Local Embedding Models 2026 (nomic, BGE-M3, sentence-transformers) — Dev Corner
- Adapting Multilingual Embedding Models to Turkish — ResearchGate