
Çoğu insan yapay zekâyı bir web sitesine yazıp cevap almakla eşit tutar. Ama o modellerin küçük akrabaları, tam da şu an masanızdaki bilgisayarda çalışabilir.
Bu yazıda neden yerel çalıştırmak isteyesiniz, bunu kolaylaştıran Ollama nedir, koca bir model küçük bir belleğe nasıl sığar ve elinizdeki bilgisayar neye yeter gibi soruları cevaplayacağız.
Neden yerel? Üç sağlam sebep
Bu üç sebep, aslında bu blogda döndüğümüz iki büyük fikirle birebir örtüşüyor: egemenlik (veri yurt içinde ve kurum içinde kalır) ve verimlilik (buluta bağımlı olmayan, ucuz çözüm). Kaynağı kısıtlı bir ekosistem için yerel model, lüks değil doğal bir tercih.
Ollama: "model için Docker"
Birkaç yıl önce yerel model çalıştırmak eziyetti. Bugün Ollama bu işi neredeyse tek komuta indirdi. Ollama'yı "diller modeli için Docker" gibi düşünün: modeli indirmeyi, doğru formatta saklamayı, ekran kartınızı otomatik kullanmayı ve bir API sunmayı sizin yerinize halleder.
Yerel bir modeli çalıştırmak kabaca bu kadar (temsili):
$ ollama run llama3                            # modeli indir + çalıştır
>>> Merhaba! Sana nasıl yardımcı olabilirim?   # artık makinende
Perde arkasında Ollama, llama.cpp adlı güçlü bir motorun üzerine kuruludur; aynı motor LM Studio gibi görsel araçları da besler. Yani terminal sevmiyorsanız, LM Studio gibi bir arayüzle fare tıklamalarıyla da aynı işi yapabilirsiniz.
Bilgisayara sığdırma: quantization
Peki milyarlarca parametreli bir model, mütevazı bir ekran kartına nasıl sığıyor? Cevap: quantization. Modelin sayılarını 16-bit hassasiyetten 4-bit'e "sıkıştırmak"; tıpkı yüksek çözünürlüklü bir fotoğrafı, gözle fark edilmeyecek kadar az kayıpla küçültmek gibi.
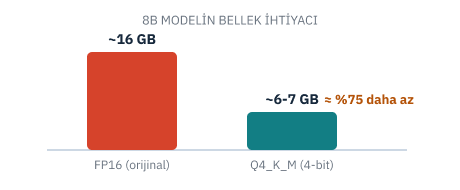
Bu sıkıştırılmış modeller GGUF denen tek dosyalık bir formatta paketlenir (ağırlıklar + tokenizer + her şey bir arada). GGUF, yerel çalıştırmanın ortak standardıdır; Ollama, LM Studio, Jan gibi araçların hepsi doğrudan bu dosyaları okur. "Q4_K_M" gibi etiketler de sıkıştırma seviyesini gösterir; çoğu kullanıcı için Q4_K_M yeterli ve dengeli.
Bilgisayarım neye yeter?
En pratik soru bu. Kabaca yol gösterici bir tablo (4-bit / Q4_K_M ile):
| Model boyutu | Gereken bellek (VRAM) | Örnek donanım |
|---|---|---|
| ~8B (ör. bir Türkçe-Llama) | ~6-7 GB | 8 GB ekran kartı (RTX 3060/4060) rahat |
| ~32B | ~22-24 GB | 24 GB ekran kartı (RTX 4090 vb.) |
| Ekran kartı yok (CPU) | ≥8 GB RAM | Çalışır, ama 5-10 kat daha yavaş |
İki pratik not: Apple Silicon (M serisi) Mac'ler, "birleşik bellek" sayesinde yerel model çalıştırmada şaşırtıcı derecede iyidir. Ve en büyük kısıt her zaman bellektir: model belleğe sığmıyorsa hız uçuruma yuvarlanır.
Ne çalıştırabilirim? (Türkçe dâhil)
Açık kaynak modellerin neredeyse tamamı yerelde çalışır: Llama, Gemma, Qwen ve daha fazlası. Ama asıl güzel haber bizim için: Türkçe modeller de yerelde çalışıyor.
- Cosmos'un Türkçe-Llama'sı GGUF formatında Hugging Face'te hazır; indirip Ollama/LM Studio ile çalıştırabilirsiniz.
- Kumru, 16 GB'lık mütevazı bir ekran kartında çalışacak şekilde tasarlandı; kurum içi, veri dışarı çıkmadan.
Sınırlar: her işin aracı değil
Dürüst olalım. Yerelde çalıştırdığınız modeller, buluttaki en dev modeller kadar "her şeyi bilen" olmayacak; genelde daha küçük ve daha uzman modellerdir. Karmaşık, açık uçlu, geniş genel bilgi isteyen işlerde büyük bulut modelleri hâlâ önde. Ayrıca donanımınız yetersizse hız can sıkabilir.
Ama bu bir kusur değil, bir tercih. "LLM ne zaman kullanılır" ve "büyük mü küçük mü" yazılarımızdaki mantık burada da geçerli: belirli, tekrarlı, gizlilik isteyen işler için yerel küçük model; gerçekten genel zekâ gerektiğinde bulut. Doğru aleti doğru işe.
Rüya ikili: yerel model + yerel RAG
Yerel bir modeli, "RAG nedir" yazımızdaki fikirle birleştirin. Kendi belgelerinizi (notlar, sözleşmeler, mevzuat) yine kendi makinenizde bir "açık kitap" olarak modele sunun. Sonuç: verisi dışarı hiç çıkmayan, kaynağa dayalı, ücretsiz ve çevrimdışı çalışan kişisel bir asistan. Egemenlik ve verimlilik tam da böyle bir şey.
Özet: Ollama, yerel model çalıştırmayı tek komuta indirdi. Nicemleme (4-bit) ve GGUF sayesinde koca modeller mütevazı donanıma sığıyor. 8B bir Türkçe model, 8 GB'lık bir kartta rahat çalışır. Gizlilik, çevrimdışılık ve ücretsizlik; hepsi cebinizde.
Yapay zekâyı gerçekten anlamanın en iyi yolu, ona dokunmaktır. Bir komut, birkaç gigabayt ve masanızda kendi yapay zekânız. Denemekten daha iyi bir öğrenme yok.