
Hatırlarsanız, dil modellerinin en tehlikeli huyu halüsinasyondu: kendinden emin bir tonla, tamamen uydurma bir cevap vermesi. Peki ya modele "sallamak yerine, şu belgelere bakıp öyle cevap ver" diyebilseydik? İşte RAG tam olarak bunu yapar.
RAG, son yılların en çok konuşulan ve en çok kullanılan yapay zekâ desenlerinden biri. Kulağa teknik gelse de fikri son derece sezgisel. Bu yazıda ne olduğunu, nasıl çalıştığını, neden işe yaradığını ve ne zaman yaramadığını sade bir dille anlatıyoruz.
Kapalı kitap vs açık kitap sınavı
En basit benzetme şu. Sıradan bir dil modeline soru sormak, birine kapalı kitap sınavı yaptırmak gibidir: sadece kafasında ezberlediğiyle cevap verir. Bilmiyorsa bile, boş bırakmak yerine "makul görünen" bir şey uydurur. Sonuç: bazen doğru, bazen kendinden emin bir yalan.
RAG (Retrieval-Augmented Generation, "Getirmeyle Zenginleştirilmiş Üretim") bu sınavı açık kitaba çevirir. Model cevap vermeden önce, konuyla ilgili gerçek belgeleri açar, ilgili yeri bulur ve cevabını o metne dayandırır. Ezberden değil, kaynaktan konuşur.
Tek cümlede RAG: Modele soruyu doğrudan sormak yerine: önce ilgili belgeleri getir, o belgeleri soruyla birlikte modele ver, model cevabı o belgelere dayandırarak üretsin.
RAG nasıl çalışır? İki aşama
RAG iki aşamadan oluşur. Biri önceden hazırlık (belgeleri düzenleme), diğeri soru anında çalışan kısım.
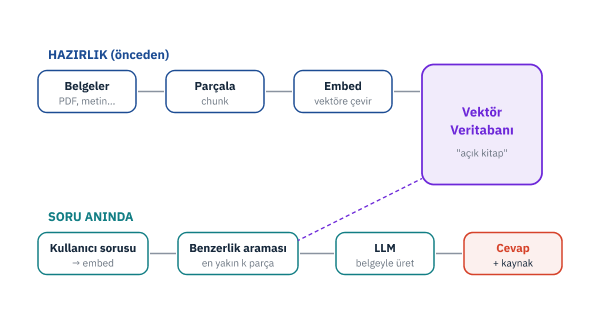
Adım adım özetleyelim. Hazırlık aşamasında belgeleriniz küçük parçalara (chunk) bölünür, her parça bir "anlam vektörüne" (embedding) çevrilir ve bir vektör veritabanına kaydedilir. Soru anında kullanıcının sorusu da bir vektöre çevrilir, veritabanında ona anlamca en yakın parçalar bulunur (benzerlik araması), bu parçalar soruyla birlikte modele verilir ve model cevabını bu gerçek metne dayanarak üretir; çoğu zaman kaynağını da göstererek.
"Anlam araması" neden önemli? Klasik arama kelime eşleştirir; RAG anlam eşleştirir. "Araç kiralama ücreti" diye sorduğunuzda, belgede "otomobil kira bedeli" yazsa bile onu bulur. Bunu mümkün kılan embedding'lerdir; bu konuyu ayrı bir yazıda derinleştireceğiz.
Neden halüsinasyonu azaltıyor?
Sihir tek kelimede: dayanak (grounding). Model artık boşluğu hayal gücüyle doldurmak zorunda değil; önüne konan gerçek metne bakarak cevap veriyor. Bu, uydurma ihtimalini ciddi biçimde düşürüyor.
Bir ek avantaj daha: RAG modeli, eğitim tarihine hapsolmaz. Yeni bir belgeyi veritabanına eklediğiniz an, model o bilgiyi "bilir" hâle gelir; yeniden eğitmeye gerek kalmadan. Şirket içi dokümanlar, güncel mevzuat, sık değişen fiyatlar gibi durumlarda bu paha biçilmez.
Ama RAG sihirli değnek değil
Dürüst olalım: RAG kurmak kolay, iyi kurmak zordur. Ve en sık yapılan hata, sorunu yanlış yerde aramaktır.
Araştırmalar çarpıcı: üretime alınan RAG projelerinin büyük kısmı ciddi sorun yaşıyor ve bu sorunların yaklaşık %73'ü modelden değil, "getirme" (retrieval) aşamasından kaynaklanıyor. Yani model iyi olsa bile, yanlış ya da eksik belge getirilirse cevap da kötü olur. Zinciri şöyle düşünün: zayıf belge → zayıf parçalama → zayıf getirme → zayıf cevap.
Yine karşımızda: veri kalitesi RAG'in performansı, beslendiği belgelerin kalitesine sıkı sıkıya bağlı. Düzenli, temiz kaynaklarda getirme doğruluğu %85-92'ye çıkarken, dağınık kaynaklarda %45-60'a düşebiliyor. "Çöp girerse çöp çıkar" kuralı burada da geçerli; Türkçe veri yazımızı hatırlayın.
RAG mı, ince ayar mı?
Sık karışan bir soru. Cevap: ikisi farklı işe yarar, rakip değiller. LoRA yazımızdaki ince ayar modele bir beceri veya tarz öğretir ("böyle konuş, bu formatta cevapla"). RAG ise modele bilgi ve kaynak verir ("şu belgelere göre cevapla"). Biri nasıl davranacağını, diğeri neye dayanacağını belirler.
| RAG | İnce ayar (LoRA) | |
|---|---|---|
| Ne verir? | Bilgi, güncel kaynak | Beceri, tarz, format |
| Güncelleme | Belge ekle, anında | Yeniden eğit |
| Halüsinasyon | Kaynağa dayanır, düşük | Yine uydurabilir |
| En iyisi | Çoğu zaman: ikisi birden (hibrit) | |
Nitekim araştırmalar da bunu söylüyor: en yüksek doğruluğu genelde ikisinin birleşimi veriyor. Modele hem doğru davranışı öğretin (ince ayar), hem de doğru kaynağı verin (RAG).
Türkiye için neden önemli?
Burada iki tezimiz güzelce birleşiyor. Birincisi: RAG, küçük bir Türkçe modeli sınıf atlatır. Devasa bir modele ihtiyacınız kalmaz; küçük ve verimli bir modele iyi bir "açık kitap" verdiğinizde, o kitap sayesinde uzman gibi cevap verir. Kaynağı kısıtlı bir ekosistem için bu, ham güce karşı zekice bir kaldıraç.
İkincisi: RAG, veriyi yerinde tutmanın yoludur. Kendi belgelerinizi (şirket içi dokümanlar, mevzuat, sağlık kayıtları) dışarı vermeden, kendi sunucunuzdaki bir modele "açık kitap" olarak sunabilirsiniz. Gizlilik ve egemenlik açısından biçilmiş kaftan. Tek şart: o belgelerin temiz ve düzenli olması, yani yine veri meselesi.
lleaderboard açısından
Bir modelin gerçek hayattaki değeri, çıplak bilgisinden çok, doğru kurulmuş bir sistemin içinde ne kadar işe yaradığıyla ölçülür. RAG, Türkçe modelleri gerçek işlerde kullanılabilir kılan köprüdür. lleaderboard'da modelleri değerlendirirken bu pratik boyutu, bir modelin RAG içinde nasıl davrandığını da gözetmek, "kâğıt üstü" skorların ötesine geçmek demek.
Özet: RAG, modele açık kitap verir: cevabı ezberden değil, gerçek belgeden bulur. Halüsinasyonu düşürür, bilgiyi güncel tutar. Ama kalitesi, beslendiği belgelerin kalitesi kadardır. İnce ayarın rakibi değil, tamamlayıcısıdır.
Bir modele "bilmiyorsan uydurma, bak ve öyle söyle" diyebilmek, belki de yapay zekâyı güvenilir kılan en önemli adım. RAG, bu basit ama güçlü fikrin adı.
Kaynaklar
- RAG Pipeline Deep Dive: Ingestion, Chunking, Embedding, Vector Search — Medium
- Best Chunking Strategies for RAG Pipelines — Redis
- Why RAG Systems Fail in Production — DigitalOcean
- RAG Accuracy Problems: Why RAG Fails and How to Fix It — Atlan
- Optimizing LLM Performance: RAG vs. Fine-Tuning — Galileo
- What is grounding and hallucinations in AI? — K2view